
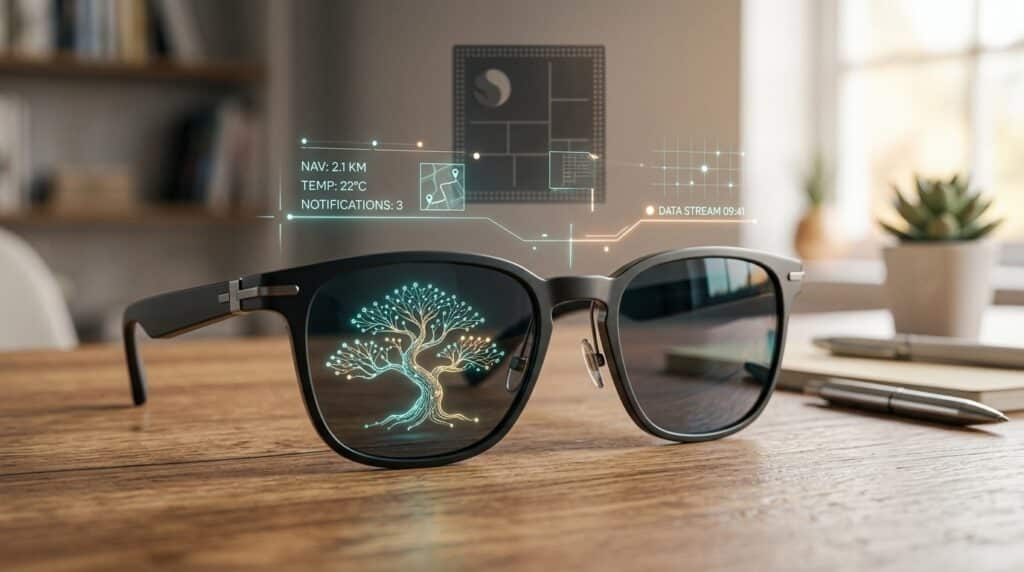

Et si la prochaine conversation avec une intelligence artificielle ne passait plus par un serveur lointain, mais par la monture posée sur votre nez ? L’idée n’a plus rien d’un slogan de salon. Au Snapdragon Summit, Qualcomm a montré qu’un modèle de langage minuscule, conçu par la jeune pousse californienne PrismML, pouvait déjà tourner localement sur des lunettes bâties autour de la plateforme Snapdragon AR1 Gen 1. Pas de nuage pour interpréter une scène. Pas d’aller-retour réseau pour nommer un objet. Une question posée à voix basse, une réponse qui arrive depuis la puce elle-même.
Quand Une Startup De Caltech Force Le Regard Vers L’IA De Poche
Le récit commence loin des stands lumineux. PrismML est née dans l’orbite de Caltech. Son fondateur, Babak Hassibi, professeur et spécialiste de la compression, a passé des années à chercher comment réduire un réseau de neurones sans lui voler sa capacité à raisonner. Autour de lui, d’autres chercheurs issus du même campus, parmi lesquels Sahin Lale, Omead Pooladzandi et Reza Sadri. En conseil, on retrouve Ion Stoica, figure de Berkeley, cofondateur de Databricks et directeur du Sky Computing Lab. Ce n’est pas un hasard de pedigree. La thèse de la maison est presque obstinée : la prochaine avancée ne viendra pas seulement d’un modèle plus gros, mais d’une densité d’intelligence plus élevée.
En mars 2026, la société sortait de l’ombre avec une famille de modèles baptisée Bonsai. Le nom n’est pas décoratif. Un bonsaï concentre la forme d’un arbre dans un volume minuscule. C’est exactement le pari. Des poids binaires, +1 ou -1, de bout en bout. Pas de couche secrète en pleine précision pour rattraper le coup. Le premier étendard, Bonsai 8B, tenait dans un peu plus d’un gigaoctet tout en restant compétitif face à des modèles 8 milliards de paramètres en précision classique. Depuis, la lignée s’est étoffée, jusqu’à un Bonsai 27B pensé pour tenir dans la mémoire d’un téléphone haut de gamme.
Le 23 septembre 2026, à Pasadena d’abord puis sur la scène Qualcomm, le laboratoire a présenté une variante taillée pour les lunettes. Un modèle multimodal d’environ deux milliards de paramètres, construit sur Bonsai 1.7B, capable de relier ce que voit la caméra et ce que dit le porteur. Le message commercial est simple : on peut enfin poser une question sur ce que l’on regarde, en temps réel, sans envoyer l’image ailleurs.
Ce Que Qualcomm A Vraiment Montré Sur Scène
Il faut séparer le spectacle et la mécanique. Qualcomm n’a pas dévoilé une paire grand public estampillée PrismML. La démonstration portait sur des lunettes de référence alimentées par Snapdragon AR1 Gen 1. Le modèle 1 bit a été optimisé pour le Hexagon NPU, avec un chemin logiciel interne basé sur le kit QNN et des noyaux capables d’exécuter des poids binaires. C’est un détail d’ingénierie, mais c’est aussi le cœur de l’affaire. Une compression brillante qui resterait coincée sur GPU de data center n’aurait aucun intérêt pour une monture de quarante grammes.
Les chiffres avancés par l’équipe sont précis. Sur une configuration à 4 Go de mémoire, les poids du modèle de langage passeraient d’environ 1,66 Go en 4 bits à 0,43 Go en 1 bit, soit près de quatre fois moins. Le débit de génération grimperait d’environ 7,4 à plus de 15 jetons par seconde. Autrement dit : plus de paramètres dans le même tiroir mémoire, et une conversation qui ne s’essouffle pas dès la deuxième phrase. Le modèle lunettes combine un cœur langage 1,7 milliard en 1 bit et un encodeur vision d’environ 300 millions de paramètres en 4 bits. La fenêtre de contexte reste courte, de l’ordre de 1 024 jetons. Ce n’est pas un assistant de roman. C’est un compagnon de scène.
Nous avons passé des années à développer la théorie mathématique nécessaire pour compresser un réseau neuronal sans perdre ses capacités de raisonnement.
Babak Hassibi, cofondateur et dirigeant de PrismML
Cette phrase, reprise depuis la sortie de stealth, éclaire le partenariat. Qualcomm cherche des expériences d’IA qui tiennent dans une lunette sans vider la batterie en vingt minutes. PrismML cherche une preuve que ses poids extrêmes ne sont pas seulement un exploit de banc d’essai. Les deux intérêts se croisent sur le NPU Hexagon.
Pourquoi Les Lunettes Changent La Règle Du Jeu
Un téléphone pardonne beaucoup. On le pose, on le recharge, on accepte une latence d’une seconde. Une lunette ne pardonne presque rien. Le champ de vision est le monde réel. La question arrive souvent pendant que l’on marche, que l’on cuisine, que l’on tend un document à quelqu’un. Si la réponse met trois secondes et que l’image a déjà quitté le cadre, l’expérience s’effondre. D’où l’obsession du local.
Traiter sur l’appareil évite aussi un autre écueil, plus politique que technique. Une caméra portée en permanence filme des visages, des intérieurs, des écrans de travail. Envoyer ce flux vers un laboratoire propriétaire, même avec de belles clauses de confidentialité, crée une tension que beaucoup d’utilisateurs sentent déjà. PrismML le dit sans détour : mieux vaut un modèle aux poids ouverts, qui exploite le silicium déjà présent, plutôt qu’une dépendance aux promesses d’un cloud vorace en calcul.
- La scène reste sur la monture, pas sur un serveur.
- La latence se mesure en fractions de seconde plutôt qu’en allers-retours réseau.
- La batterie n’a plus à nourrir une radio en continu pour chaque phrase.
- Le fabricant de lunettes peut différencier son produit sans revendre toute la relation utilisateur à un géant du modèle.
Ce dernier point intéresse autant les startups hardware que les opérateurs historiques. Meta a inondé ses événements de montures connectées. D’autres acteurs asiatiques et européens préparent des références AR1. Si un modèle compact et ouvert devient un ingrédient standard, la bataille se déplace du « qui possède le plus gros modèle » vers « qui conçoit la meilleure boucle perception-action dans un format portable ».
Comprendre Le Pari Du 1 Bit Sans Jargon Inutile
Dans un modèle classique, chaque poids occupe 16 bits, parfois 8, parfois 4 après quantification. Réduire à 1 bit, c’est presque caricaturer le neurone : il n’a plus le droit qu’à un signe. On pourrait croire que tout s’écroule. Or la recherche de ces dernières années, et le travail théorique revendiqué par l’équipe de Caltech, montre qu’une bonne mise à l’échelle par groupes, une architecture adaptée et un entraînement pensé dès le départ pour cette contrainte peuvent préserver l’essentiel du raisonnement.
PrismML insiste sur un point que d’autres laboratoires de quantification évitent parfois : pas de « trappe » en haute précision au milieu du réseau. Les embeddings, l’attention, les blocs MLP, tout est ramené à cette représentation extrême, avec un facteur d’échelle par groupes. Le résultat n’est pas magique. Sur les bancs de test, le 1 bit lâche un peu de terrain par rapport au modèle source. Mais l’écart reste assez faible pour que l’usage quotidien — décrire une scène, lire une étiquette, répondre à une consigne courte — tienne debout.
| Point de comparaison | Modèle 4 bits proche | Bonsai 1 bit lunettes |
| Mémoire des poids langage | environ 1,66 Go | environ 0,43 Go |
| Débit observé | environ 7,4 jetons/s | environ 15,4 jetons/s |
| Paramètres utiles | classe 1,7 B | classe 2 B vision-langage |
| Lieu d’exécution | souvent trop lourd | NPU Hexagon, sur lunettes |
Ces ordres de grandeur suffisent à comprendre l’enthousiasme des intégrateurs. Quatre fois plus de paramètres dans le même budget mémoire, ce n’est pas une ligne de communiqué. C’est la différence entre un gadget qui répète trois phrases apprises et un petit modèle multimodal qui reconnaît un objet, le relie à une question, et formule une réponse cohérente.
La Famille Bonsai, Plus Large Que La Démo Lunettes
Réduire PrismML à une démo Qualcomm serait injuste. La société a déjà publié plusieurs tailles. Bonsai 1.7B et 4B visent les téléphones et les objets très contraints. Bonsai 8B a servi de preuve de concept grand public. Bonsai 27B, annoncé à l’été 2026 et basé sur une souche Qwen, pousse l’idée jusqu’à une classe de modèles que l’on réservait encore récemment aux racks. Une variante ternaire occupe environ 5,9 Go. Une variante 1 bit descend vers 3,9 Go. Les poids sont diffusés sous licence Apache 2.0. Le laboratoire affirme des millions de téléchargements depuis les premières versions.
Cette ouverture n’est pas seulement généreuse. Elle sert une stratégie. Plus les développeurs branchent Bonsai sur llama.cpp, MLX, CUDA ou désormais QNN, plus le modèle devient un standard de fait pour l’inférence de bord. Qualcomm, de son côté, gagne un exemple concret à montrer aux fabricants de lunettes : voilà ce que votre NPU peut faire quand le modèle est pensé pour lui, et pas seulement quantifié après coup.
Les investisseurs suivent le même fil. Khosla Ventures, Cerberus et Caltech ont accompagné un tour d’amorçage d’environ 16,25 millions de dollars. Ce n’est pas le chèque d’un laboratoire de fondation qui brûle des milliards en pré-entraînement. C’est le financement d’une thèse d’efficacité. Dans un marché où l’électricité des data centers devient un sujet politique, vendre de l’intelligence par watt a soudain un argumentaire très concret.
Ce Que L’Utilisateur Pourrait Vivre Au Quotidien
Imaginons une matinée banale. Vous enfilez les lunettes en sortant. Dans la rue, vous demandez le nom d’un arbre dont la plaque est illisible. Le modèle local croise l’image et une courte mémoire de contexte. Dans un supermarché étranger, vous pointez une boîte et obtenez la liste d’allergènes traduite, sans ouvrir une application. Au bureau, vous regardez un schéma au tableau et demandez une reformulation en une phrase. Rien de tout cela n’exige un roman généré de trois pages. Tout cela exige de la vitesse, de la discrétion et une compréhension visuelle minimale.
Le modèle présenté n’est pas un oracle universel. Sa fenêtre courte interdit les longues conversations à rebondissements. Son encodeur vision reste petit. Les bancs multimodaux montrent d’ailleurs que la compression 1 bit coûte davantage sur la vision que sur le texte. Il faudra donc des interfaces astucieuses : questions brèves, réponses brèves, confirmation possible d’un geste ou d’un regard. Les meilleures lunettes ne seront pas celles qui parlent le plus, mais celles qui parlent juste au bon moment.
- Identifier un objet ou un panneau sans sortir le téléphone.
- Résumer à voix haute une étiquette trop petite.
- Guider une tâche manuelle en commentant ce que voit la caméra.
- Rester utilisable dans le métro, en avion, dans une zone blanche.
Ces usages sonnent modestes. Ils sont pourtant ceux qui décident de l’adoption. Les premiers acheteurs de lunettes connectées n’attendent pas un clone de grand modèle de fondation dans 30 grammes de plastique. Ils attendent qu’un objet porté toute la journée ne les trahisse ni sur la latence, ni sur la vie privée, ni sur l’autonomie.
Le Contexte Concurrentiel Ne Dort Pas
PrismML n’est pas seule sur le créneau de la compression extrême. D’autres équipes travaillent la quantification agressive, les modèles nativement binaires, les architectures pensées pour NPU. Les grands laboratoires propriétaires, eux, multiplient les versions « lite » destinées au téléphone, tout en gardant le cerveau lourd dans le cloud. La différence de PrismML tient à l’alignement entre recherche théorique, poids ouverts et partenariat silicium.
Qualcomm, de son côté, a besoin de preuves. Le marché des lunettes a déjà connu des hivers. Les premières vagues promettaient la réalité augmentée totale et livraient surtout une caméra un peu trop visible. L’arrivée d’une IA locale crédible donne un nouvel argument : la monture n’est plus seulement un accessoire photo, c’est un capteur qui comprend. Meta l’a compris en saturant ses keynotes de scénarios assistés. Apple, selon certaines rumeurs jamais confirmées par Hassibi, observerait le sujet de très près. Personne n’a encore annoncé une paire commerciale embarquant Bonsai. Cette absence est importante. Une démo de sommet n’est pas un produit en rayon.
Réduire les modèles à des représentations 1 bit change l’équation d’optimisation. Cela rend possible une nouvelle classe de systèmes, efficaces en bordure comme dans le nuage.
Ion Stoica, conseiller de PrismML, professeur à UC Berkeley
Cette phrase replace le sujet au bon niveau. Il ne s’agit pas seulement de lunettes. Il s’agit d’une économie du calcul. Si un modèle de deux milliards de paramètres tient dans moins d’un demi-gigaoctet et parle à 15 jetons par seconde sur un NPU de lunettes, alors robots domestiques, outils industriels portés, aides auditives intelligentes et capteurs médicaux deviennent des cibles réalistes. Le wearable n’est que la vitrine la plus photogénique.
Les Limites Qu’Il Faut Dire Avant L’Emballement
Un article honnête doit aussi lister ce qui cloche encore. D’abord, aucun fabricant n’a officialisé un produit fini. Ensuite, un contexte de 1 024 jetons bride la mémoire de travail. Une conversation un peu longue, un document un peu dense, et le modèle oublie le début. La vision, compressée, restera fragile sur les scènes complexes, la nuit, les reflets, les écritures manuscrites. Les benchmarks de laboratoire ne disent pas grand-chose d’une rue parisienne sous la pluie.
Il y a aussi la question thermique. Une lunette dissipe mal. Un NPU qui génère 15 jetons par seconde pendant une visite guidée de deux heures n’a pas le droit de chauffer la tempe. Les chiffres de débit sont mesurés dans des conditions de démo. La vie réelle ajoutera le suivi de tête, la stabilisation d’image, le réveil vocal, le Bluetooth des écouteurs. Le budget énergétique se morcelle vite.
Enfin, l’ouverture des poids ne résout pas toute la gouvernance. Un modèle local peut quand même se tromper, halluciner une allergie, mal lire un médicament. Plus l’interface est portée, plus l’erreur a des conséquences immédiates. Les futurs produits devront afficher l’incertitude, proposer une confirmation, journaliser ce qui a été vu sans transformer la monture en mouchard.
Ce Que Cette Alliance Dit De La Suite Des Startups IA
Depuis deux ans, le récit dominant valorisait l’échelle. Plus de données, plus de puces, plus de paramètres. Une contre-histoire émerge, plus discrète, portée par des laboratoires comme PrismML : extraire davantage d’intelligence par octet et par joule. Cette contre-histoire séduit les fonds qui n’ont pas les moyens de financer un cluster souverain, et les industriels qui refusent de livrer leurs données à un API tierce.
Le partenariat Qualcomm est, de ce point de vue, un rite de passage. Tant qu’un modèle 1 bit restait sur GitHub et sur quelques Mac, il intéressait les curieux. Dès qu’il parle depuis une lunette de référence, il intéresse les chefs de produit. On peut s’attendre à d’autres ports : robots mobiles, casques industriels, tablettes durcies, bornes hors ligne. Chaque port sera une négociation entre architecture du modèle et idiosyncrasies du NPU.
Pour les fondateurs francophones qui regardent cette séquence, la leçon n’est pas « il faut quantifier à 1 bit ». La leçon est plus sèche. Choisir une contrainte matérielle réelle, souvent négligée par les laboratoires de fondation, et en faire le centre de gravité de la recherche. Ici, la contrainte s’appelle grammes, milliwatts, mémoire partagée et caméra toujours allumée. Ailleurs, ce sera le determinisme d’un robot chirurgical ou la latence d’un assistant d’entrepôt.
Une Lecture Plus Large : Vie Privée, Souveraineté, Design
Dès que l’intelligence quitte le data center, trois débats reviennent. Premier débat, la vie privée. Un modèle local n’est pas innocent. Il voit. Il peut stocker des embeddings. Il peut être mis à jour à distance. Mais il retire au passage l’habitude toxique d’envoyer chaque image vers une ferme de GPU. Pour l’Europe, où le réflexe réglementaire est plus vif, cette architecture locale offre un argument de conformité plus solide qu’une clause de sous-traitance.
Deuxième débat, la souveraineté industrielle. Si les lunettes du quotidien dépendent d’un unique modèle fermé, le fabricant n’est plus qu’un habillage. Un poids ouvert, même imparfait, redonne une prise. On peut l’auditer, le fine-tuner sur un corpus métier, le figer dans une version certifiée. Les hôpitaux, les usines, les collectivités y sont sensibles.
Troisième débat, le design. Une IA dans des lunettes force à repenser l’interface. Plus de clavier. Moins d’écran. Beaucoup de regard. Le modèle 2B de PrismML, limité, impose déjà une écriture des expériences : phrases courtes, confirmation visuelle, silence par défaut. Ce silence est une qualité. Un assistant qui commente tout ce que vous voyez devient vite insupportable. Les meilleures intégrations seront celles qui savent se taire.
Comment Lire Les Prochaines Annonces Sans Se Faire Avoir
Les mois qui viennent produiront des communiqués. Certains parleront de « première lunette IA complète ». D’autres colleront le mot Bonsai sur une fiche produit sans dire si l’inférence est vraiment locale, ou seulement un mode dégradé quand le réseau tombe. Voici une grille simple, presque artisanale, pour lire ces textes.
- Le modèle tourne-t-il entièrement sur la monture, y compris la partie vision ?
- Quelle est la fenêtre de contexte réelle en usage, pas en fiche technique ?
- Quel débit tient après vingt minutes, batterie à 40 %, processeur thermique limité ?
- Les poids sont-ils auditable, ou seulement « inspirés » d’un modèle ouvert ?
- Une mise à jour cloud peut-elle réactiver un envoi d’images par défaut ?
Si ces questions restent sans réponse, on a affaire à une démo habillée. Si elles trouvent des réponses chiffrées, on tient peut-être le début d’une catégorie. PrismML et Qualcomm ont ouvert la porte. Ils n’ont pas encore livré la maison.
Le Fil Qui Relie Caltech, Berkeley Et Un NPU De Lunettes
Il y a quelque chose de presque vieux monde dans cette histoire, et c’est ce qui la rend attachante. Un professeur de Caltech qui retravaille la théorie de la compression. Un conseiller de Berkeley qui a passé sa carrière à rendre les systèmes distribués moins absurdes. Une société de puces qui a besoin d’occupants intelligents pour son NPU. Personne ici ne prétend réécrire à lui seul le destin de l’intelligence artificielle. Chacun pousse une variable : la taille du poids, le lieu du calcul, le format de l’objet porté.
On peut se moquer de l’esthétique « petit modèle, grand discours ». On peut aussi reconnaître que le discours colle enfin à un objet. Une lunette n’a pas de place pour un modèle de 70 milliards de paramètres. Elle a de la place pour 430 mégaoctets bien employés et pour une conversation qui ne traverse pas l’océan. C’est une contrainte. C’est aussi un style.
Dans les rédactions, on a trop longtemps raconté l’IA comme une course de taille. Les laboratoires de fondation continueront cette course, et ils auront raison sur certains usages. Mais une autre course a commencé, plus étroite, plus physique, plus proche du visage. PrismML vient d’y poser un jalon visible. Reste à savoir quel fabricant osera graver ce jalon dans une monture que l’on achètera vraiment.
Et Maintenant, Que Surveiller Concrètement ?
Trois signaux vaudront mieux que cent keynotes. Premier signal : l’apparition d’un SDK lunettes où Bonsai n’est plus une démo interne mais une option documentée pour les développeurs tiers. Deuxième signal : un fabricant nommé, avec autonomie annoncée et scénarios filmés hors plateau. Troisième signal : des mesures indépendantes de consommation, pas seulement des jetons par seconde en salle climatisée.
En attendant, la leçon utile tient en une phrase un peu sèche, donc durable. L’intelligence artificielle n’a plus seulement besoin de cathédrales de calcul. Elle a besoin de formes qui acceptent le monde tel qu’il est : mobile, bruyant, privé, imparfaitement alimenté. Une paire de lunettes, un modèle 1 bit, un NPU déjà là. Ce n’est pas la fin de l’histoire. C’est peut-être enfin un début à la bonne échelle.
Les lecteurs qui suivent les startups le savent : les alliances silicium-modèle se jugent six mois plus tard, quand le stand s’est éteint. Si d’ici là une monture grand public fait tourner un Bonsai sans supplier le cloud à chaque regard, PrismML aura gagné plus qu’un créneau de conférence. Elle aura déplacé, d’un cran discret, l’endroit où l’on croit que l’intelligence doit habiter.
