
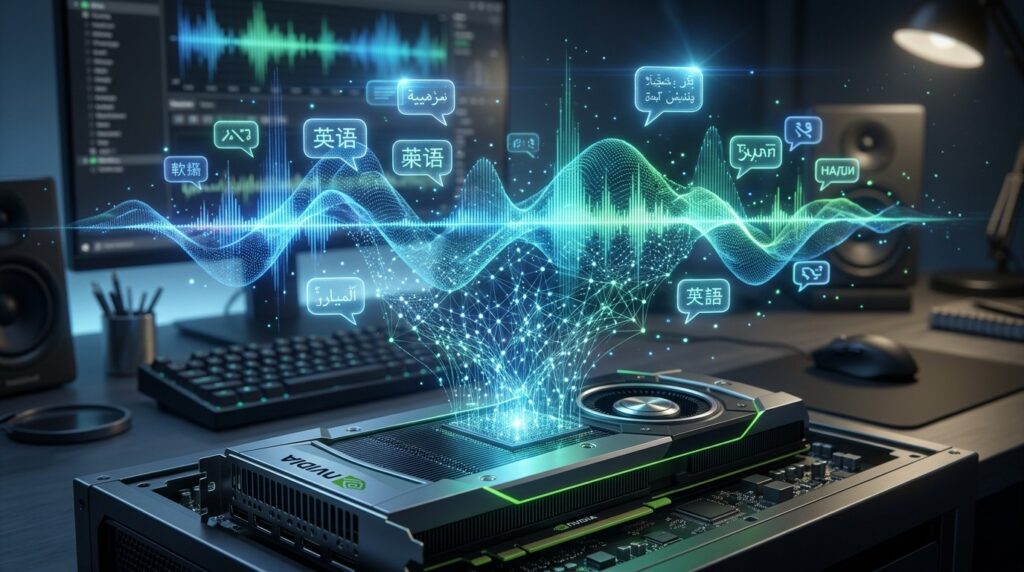

Imaginez un outil capable de transformer une heure de réunion en texte clair, de distinguer jusqu’à huit voix différentes et de basculer entre plus de trente langues, le tout sans frais de licence et capable de tourner sur une seule puce. C’est exactement ce que Nvidia vient de déposer sur la table avec Nemotron 3.5 Transcribe. Dans un secteur où la voix devient le nouveau terrain de jeu des startups, cette sortie change la donne.
Un modèle ouvert qui redéfinit la transcription audio
Le marché de l’intelligence artificielle vocale tourne à plein régime. Les entreprises cherchent des solutions fiables pour retranscrire des réunions, des consultations médicales ou des appels clients. Jusqu’ici, beaucoup dépendaient de services cloud fermés, souvent coûteux et limités. Nvidia a décidé de casser ce schéma en proposant un modèle open-weight entièrement gratuit.
Nemotron 3.5 Transcribe arrive avec des arguments solides. Il gère jusqu’à quarante langues, traduit trente et une d’entre elles vers l’anglais et inversement, et revendique de meilleures performances que ses concurrents sur le leaderboard Open ASR de Hugging Face. Pour les développeurs, c’est une aubaine. Plus besoin de payer des API au volume ni de se contenter de modèles trop légers qui perdent en précision.
Le modèle pèse environ trente milliards de paramètres. C’est imposant, mais Nvidia insiste sur un point crucial : il peut fonctionner sur une seule puce. Que ce soit le Jetson AGX Thor destiné à la robotique, le DGX Spark qui équipe les nouveaux ordinateurs portables ou les puces Blackwell des centres de données, l’architecture a été pensée pour rester accessible. Cette approche change la manière dont les startups peuvent déployer des solutions vocales en local, sans dépendre systématiquement du cloud.
Les points forts techniques qui font la différence
Commençons par la durée. Nemotron 3.5 Transcribe accepte des enregistrements allant jusqu’à une heure. Beaucoup de solutions concurrentes segmentent le fichier ou perdent en qualité au-delà de quelques minutes. Ici, le modèle traite l’ensemble d’un seul bloc, ce qui simplifie grandement le pipeline de traitement.
Ensuite vient la diarisation. Identifier jusqu’à huit locuteurs distincts dans une même conversation représente un atout majeur pour les comptes rendus de réunion. Imaginez une équipe de projet dispersée géographiquement. Chaque participant parle, parfois en chevauchement. Le modèle attribue correctement les interventions, ce qui permet ensuite de générer des résumés nominatifs sans intervention manuelle lourde.
La traduction constitue un autre pilier. Trente et une langues vers l’anglais et inversement ouvrent des perspectives immédiates pour les équipes internationales. Une startup française qui collabore avec des partenaires en Asie ou en Amérique latine peut désormais obtenir une transcription bilingue de qualité sans passer par plusieurs outils successifs.
Les développeurs peuvent désormais personnaliser le modèle pour reconnaître le jargon spécifique d’un secteur dans chaque langue.
Équipe Nvidia Speech
Cette capacité de personnalisation s’appuie sur le dataset Granary dans sa version 2, également publié en open source. Nvidia fournit ainsi non seulement le modèle, mais aussi les données et les outils de la suite NeMo Speech pour l’adapter à des vocabulaires métier. Médecine, finance, industrie : chaque domaine possède son propre lexique. Pouvoir l’intégrer sans repartir de zéro accélère considérablement le time-to-market des applications.
Un écosystème déjà dense autour de la voix
Nemotron 3.5 Transcribe ne sort pas dans le vide. Ces dernières semaines, plusieurs acteurs ont multiplié les annonces. Mistral a proposé Voxtral 3, ElevenLabs a lancé Realtime pour la génération de parole instantanée dans les agents vocaux, et Salesforce a dévoilé Launa-Omni. La concurrence s’intensifie, ce qui pousse chacun à se différencier.
Nvidia joue la carte de l’ouverture et de l’efficacité matérielle. Là où certains misent sur des services cloud purement SaaS, l’entreprise californienne mise sur la possibilité de faire tourner le modèle en local. Pour une startup qui traite des données sensibles, cette option change tout. Les dossiers médicaux, les conversations stratégiques ou les informations financières restent sur les serveurs de l’entreprise. La conformité RGPD et les exigences de confidentialité deviennent plus simples à gérer.
Le modèle s’inscrit dans une lignée déjà existante chez Nvidia. Le modèle Parakeet, bien plus compact avec ses 1,1 milliard de paramètres, avait déjà démontré qu’il était possible d’obtenir de solides performances avec une empreinte réduite. Nemotron 3.5 Transcribe monte en gamme tout en conservant cette philosophie d’accessibilité matérielle.
Cas d’usage concrets pour les startups et les entreprises
Les réunions d’affaires constituent le terrain le plus évident. Une startup qui multiplie les appels clients ou les points d’équipe peut automatiser la prise de notes. Le texte généré devient ensuite la base d’un résumé, d’une liste de tâches ou d’un compte rendu envoyé automatiquement. Le gain de temps est immédiat et mesurable.
Dans le domaine médical, la transcription des consultations reste un enjeu majeur. Les médecins passent encore trop de temps à rédiger leurs notes. Un modèle capable de gérer le jargon médical dans plusieurs langues et de distinguer le praticien du patient offre une piste sérieuse pour alléger cette charge. Nvidia mentionne explicitement ce cas d’usage parmi les cibles prioritaires.
Les centres d’appels et les services clients représentent un autre débouché naturel. Analyser des milliers d’heures d’enregistrements pour extraire des insights, détecter des problèmes récurrents ou former de nouveaux agents devient plus accessible. Avec un modèle open-weight, les entreprises peuvent entraîner des versions spécialisées sur leur propre historique de conversations.
Un point de vigilance demeure : le modèle travaille sur des fichiers audio enregistrés, pas encore sur des flux en direct. Pour les applications de sous-titrage live ou d’agents conversationnels temps réel, d’autres solutions restent nécessaires. Nvidia laisse toutefois entendre que l’écosystème NeMo permettra d’évoluer dans cette direction à moyen terme.
Pourquoi l’approche open-weight séduit les développeurs
L’open-weight n’est pas seulement une question de gratuité. C’est une question de contrôle. Les équipes techniques peuvent inspecter le modèle, l’affiner, le quantifier pour des puces plus modestes ou l’intégrer dans des architectures plus larges. Cette liberté contraste avec les API fermées où chaque appel est facturé et où les possibilités de personnalisation restent limitées.
Pour une startup early-stage, le calcul est simple. Au lieu de brûler du cash sur des tokens de transcription, elle investit du temps d’ingénierie pour adapter un modèle open-source à son besoin précis. Une fois le modèle fine-tuné, les coûts d’inférence deviennent ceux de l’électricité et du matériel, bien plus prévisibles.
Le dataset Granary version 2 renforce encore cette dynamique. En fournissant des données de qualité sous licence ouverte, Nvidia permet à la communauté de construire des modèles dérivés ou d’améliorer les performances sur des langues moins représentées. C’est un cercle vertueux qui profite à l’ensemble de l’écosystème.
- Accès gratuit au modèle de trente milliards de paramètres
- Support de quarante langues et traduction de trente et une d’entre elles
- Diarisation jusqu’à huit locuteurs
- Traitement d’enregistrements d’une heure
- Possibilité de fine-tuning avec NeMo Speech et Granary 2
- Exécution sur une seule puce, du edge au datacenter
Les implications pour l’écosystème startup français et européen
En Europe, la souveraineté des données et la conformité réglementaire occupent une place centrale. Un modèle qui peut tourner en local répond directement à ces préoccupations. Les startups françaises qui développent des solutions pour la santé, le juridique ou la finance y trouvent un allié de poids.
La capacité multilingue est également un atout dans un marché européen fragmenté. Une application conçue à Paris peut servir des clients en Allemagne, en Espagne ou en Italie sans multiplier les pipelines de transcription. Le modèle devient un socle commun sur lequel chaque équipe ajoute sa couche métier.
On peut aussi imaginer des usages hybrides. Certaines startups pourraient utiliser Nemotron 3.5 Transcribe pour le traitement batch des archives audio, tout en conservant un service cloud pour les besoins temps réel. L’important est de disposer d’une option open-source performante dans la boîte à outils.
Performances revendiquées et positionnement concurrentiel
Nvidia affirme que Nemotron 3.5 Transcribe surpasse les rivaux sur le tableau de bord Open ASR de Hugging Face. Ces benchmarks mesurent la précision de la reconnaissance automatique de la parole sur différents jeux de données. Une bonne position dans ce classement constitue un argument commercial fort auprès des équipes techniques qui comparent les options avant de s’engager.
Il reste toutefois prudent de tester le modèle sur ses propres données. Les benchmarks publics ne couvrent pas toujours les conditions réelles : bruits de fond, accents régionaux, qualité d’enregistrement variable ou jargon très spécifique. C’est précisément là que la possibilité de fine-tuning prend tout son sens.
Face à des acteurs comme OpenAI avec Whisper, Google avec ses modèles Speech-to-Text ou les solutions d’ElevenLabs et Mistral, Nvidia se positionne comme le fournisseur qui allie performance, ouverture et optimisation matérielle. L’entreprise ne vend pas uniquement un modèle : elle vend un écosystème de puces capables de le faire tourner efficacement.
Comment démarrer concrètement avec le modèle
Les développeurs peuvent récupérer les poids du modèle et le dataset Granary 2 via les canaux habituels de Nvidia. La suite NeMo Speech fournit les outils nécessaires pour l’inférence, le fine-tuning et l’évaluation. Pour une première expérimentation, un simple script Python permet de transcrire un fichier audio et d’obtenir le texte avec les horodatages et les identifiants de locuteurs.
Les équipes disposant déjà d’une infrastructure GPU Nvidia sont évidemment avantagées. Mais même avec des ressources plus modestes, la quantification et les optimisations disponibles dans NeMo permettent de réduire l’empreinte mémoire. Sur un laptop équipé d’une puce DGX Spark, le modèle devient utilisable pour des prototypes sérieux.
Une bonne pratique consiste à commencer par un cas d’usage limité. Transcrire les réunions internes d’une équipe, par exemple. Une fois la qualité validée et les éventuels ajustements de vocabulaire effectués, on élargit progressivement le périmètre. Cette approche itérative limite les risques et permet de mesurer rapidement le retour sur investissement.
Les limites à connaître avant de se lancer
Comme tout modèle, Nemotron 3.5 Transcribe n’est pas magique. La qualité dépend fortement de la clarté de l’enregistrement d’origine. Un micro de mauvaise qualité, un environnement bruyant ou des locuteurs qui parlent trop vite peuvent dégrader les résultats. Un prétraitement audio reste souvent nécessaire.
L’absence de support natif pour le streaming constitue une autre limite actuelle. Les applications qui nécessitent une transcription quasi instantanée devront attendre ou combiner le modèle avec d’autres solutions. Nvidia a clairement priorisé la précision et la longueur des enregistrements plutôt que la latence ultra-faible.
Enfin, même open-weight, un modèle de trente milliards de paramètres demande des ressources non négligeables. Les startups qui n’ont pas encore accès à du matériel GPU performant devront soit louer des instances cloud, soit attendre des versions quantifiées plus légères. Le modèle Parakeet reste une alternative intéressante pour les cas où la compacité prime sur la précision absolue.
Vers une généralisation de la voix comme interface
Au-delà de la transcription pure, cette sortie s’inscrit dans un mouvement plus large. La voix devient une interface de plus en plus naturelle pour interagir avec les systèmes d’information. Agents conversationnels, assistants personnels, outils de productivité : tous reposent en partie sur une compréhension fiable de la parole.
En rendant accessible un modèle performant et personnalisable, Nvidia accélère cette transition. Les startups n’ont plus besoin d’attendre que les géants du cloud baissent leurs tarifs ou ouvrent leurs modèles. Elles peuvent construire dès aujourd’hui des solutions différenciantes sur la base d’un socle technique solide.
On peut s’attendre à voir apparaître dans les prochains mois de nombreuses applications verticales. Des outils spécialisés pour les avocats, les journalistes, les chercheurs ou les formateurs. Chacun pourra adapter Nemotron 3.5 Transcribe à son domaine et proposer une expérience utilisateur plus pertinente que les solutions généralistes.
Un signal fort pour l’ensemble de l’industrie
La publication simultanée du modèle et du dataset Granary 2 montre la stratégie de Nvidia. L’entreprise ne se contente pas de vendre du hardware. Elle nourrit activement l’écosystème logiciel qui fait tourner ses puces. Plus les développeurs créent d’applications vocales optimisées pour les architectures Nvidia, plus la demande en GPU spécialisés augmente. C’est un cercle vertueux parfaitement assumé.
Pour les autres acteurs du marché, le message est clair. L’ouverture devient un argument concurrentiel de premier plan. Les modèles fermés purement SaaS devront justifier leur valeur ajoutée par une précision supérieure, une latence plus faible ou des fonctionnalités exclusives. La simple facturation à l’usage ne suffira plus face à des alternatives open-weight de cette qualité.
Les investisseurs qui suivent le secteur de la voix IA notent également ce mouvement. Les startups qui misent sur des solutions propriétaires purement cloud devront prouver qu’elles apportent une différenciation réelle. Celles qui intègrent des modèles ouverts et les enrichissent avec des données propriétaires ou une expérience utilisateur soignée semblent mieux positionnées pour les prochaines années.
Perspectives d’évolution à court et moyen terme
On peut anticiper plusieurs évolutions. D’abord, des versions quantifiées plus légères qui permettront de faire tourner Nemotron 3.5 Transcribe sur des appareils encore plus modestes. Ensuite, probablement un support progressif du streaming, même si Nvidia n’a pas encore communiqué de feuille de route précise sur ce point.
La communauté open-source devrait également s’emparer du modèle pour créer des versions spécialisées. On verra sans doute apparaître des checkpoints fine-tunés pour le français, pour le jargon médical européen ou pour des dialectes régionaux. C’est tout l’intérêt d’un modèle open-weight : il devient une base commune que chacun enrichit.
Enfin, l’intégration avec d’autres briques de l’écosystème Nvidia, notamment les modèles de génération de texte et les outils de vision, pourrait donner naissance à des pipelines multimodaux complets. Transcrire une réunion, en extraire les points clés, générer un résumé illustré et proposer des actions : le tout en local, sur des puces optimisées.
Ce que les dirigeants de startups doivent retenir
Nemotron 3.5 Transcribe n’est pas seulement un nouveau modèle de plus. C’est un outil qui réduit significativement la barrière à l’entrée pour construire des produits vocaux sérieux. Les équipes qui hésitaient encore à cause des coûts ou de la dépendance aux API cloud disposent désormais d’une alternative crédible.
Le moment est particulièrement favorable. L’intérêt pour les interfaces vocales ne cesse de croître, les réglementations sur la protection des données poussent vers des solutions locales, et le matériel capable d’exécuter ces modèles devient plus accessible. Les startups qui sauront combiner ces trois facteurs ont une fenêtre d’opportunité claire devant elles.
Il ne s’agit pas de remplacer tous les outils existants du jour au lendemain. Il s’agit plutôt d’évaluer concrètement si ce modèle peut améliorer un processus existant ou permettre de lancer une nouvelle fonctionnalité. Un prototype de quelques semaines suffit souvent à trancher.
La transcription audio n’est plus un goulot d’étranglement technologique. Elle devient une commodité de haute qualité, ouverte et adaptable. Dans ce nouveau contexte, la vraie valeur se déplace vers l’expérience utilisateur, l’intégration métier et la capacité à extraire des insights actionnables à partir du texte généré. C’est là que les startups les plus inventives feront la différence dans les mois et les années à venir.
Nvidia a posé une pierre importante. À la communauté des développeurs et des entrepreneurs de s’en saisir pour construire les prochaines générations d’applications vocales. Le terrain de jeu est ouvert, les outils sont disponibles, et les cas d’usage ne manquent pas. Il ne reste plus qu’à passer à l’action.
