

Imaginez un instant une intelligence artificielle capable de ne pas se contenter de jeter un regard rapide sur une photographie avant de tout oublier et de raisonner uniquement en mots. Que se passerait-il si, au milieu de sa réflexion, elle pouvait revenir à l’image, zoomer sur un détail précis, extraire une frame d’une vidéo ou même lancer un petit script pour mesurer une distance ? C’est exactement le pari que vient de lancer la startup Elorian avec son premier modèle baptisé Glimpse. Alors que la plupart des systèmes multimodaux traitent encore les visuels comme une simple mémoire fugace, cette jeune pousse de Palo Alto propose une approche radicalement différente : un véritable espace de brouillon visuel intégré au cœur du raisonnement.
Pourquoi les modèles actuels peinent encore à « voir » vraiment
Depuis plusieurs années, les modèles multimodaux impressionnent par leur capacité à décrire une scène, générer une légende ou répondre à une question sur une image. Pourtant, derrière cette apparente maîtrise se cache une limitation structurelle. La plupart convertissent l’image en une série de tokens une fois pour toutes, puis continuent leur raisonnement exclusivement dans l’espace textuel. C’est un peu comme si vous regardiez une photo, la rangiez dans un tiroir et tentiez ensuite de résoudre une énigme uniquement à partir de ce que vous croyez vous rappeler.
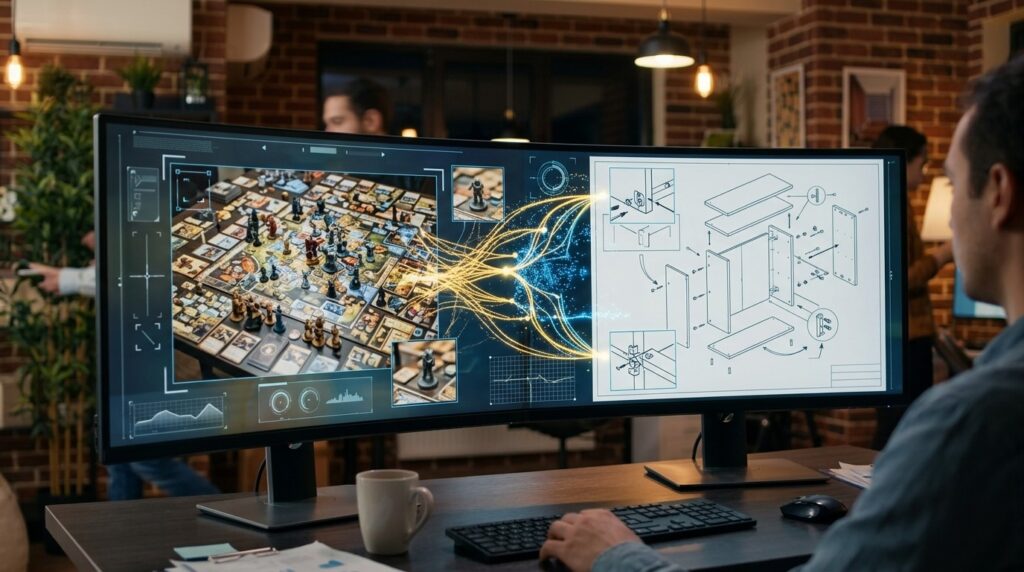
Andrew Dai, ancien chercheur chez Google DeepMind et aujourd’hui CEO d’Elorian, a vécu une illustration concrète de ce problème lors d’une simple soirée jeux. Après avoir photographié une partie de plateau fraîchement terminée, il a demandé à un modèle de pointe qui était en train de gagner. La réponse fut décevante. Les jeux de société possèdent chacun leur propre langage visuel, leurs icônes, leurs symboles et leurs conventions. Un adulte les déchiffre presque instantanément, même avec très peu de texte. Les modèles, eux, peinent encore à intuiter la signification de ces éléments.
Les humains peuvent regarder des diagrammes Ikea, sans aucun texte, et assembler un meuble. Pourquoi les modèles d’IA n’y parviennent-ils pas ?
Andrew Dai, CEO d’Elorian
Cette anecdote n’est pas isolée. Elle révèle une faille profonde : la plupart des systèmes ne maintiennent pas un accès dynamique et itératif à la source visuelle pendant qu’ils raisonnent. Ils décrivent, ils infèrent, ils hallucinent parfois, mais ils ne « reviennent pas vérifier ». Glimpse inverse cette logique en construisant le modèle autour de cette capacité de retour permanent sur l’image ou la vidéo.
Le mécanisme du visual scratch space expliqué simplement
L’innovation centrale de Glimpse repose sur ce que l’équipe appelle un visual scratch space, ou espace de brouillon visuel. Pendant que le modèle construit sa chaîne de raisonnement, il peut à tout moment décider de revenir à la source originale. Il peut recadrer une région précise, sélectionner des images clés dans une séquence vidéo, ou même exécuter du code pour effectuer des mesures, des comparaisons ou des calculs géométriques sur ce qu’il observe.
On peut le comparer à un humain qui, en train d’analyser une photo sur son téléphone, pince pour zoomer sur un détail avant de continuer sa réflexion. Cette boucle n’est pas un ajout après coup ; elle est native dans l’architecture. Elorian affirme avoir entraîné ce modèle avec une équipe restreinte et seulement quelques centaines de GPU, le rendant substantiellement plus compact que les systèmes frontier contre lesquels il est évalué.
- Retour dynamique sur l’image en cours de raisonnement
- Possibilité de recadrer ou d’extraire des frames spécifiques
- Exécution de code pour mesurer ou comparer des éléments visuels
- Architecture conçue dès le départ autour de cette boucle
- Taille de modèle réduite par rapport aux géants du marché
Cette approche n’est pas totalement inédite. OpenAI avait déjà introduit des mécanismes de crop-and-zoom pendant le raisonnement dans ses modèles de la série o en 2025. La différence revendiquée par Elorian est d’avoir bâti l’ensemble du système autour de cette idée, et ce de manière particulièrement efficiente en ressources.
Performances annoncées et positionnement tarifaire
Selon les évaluations internes communiquées par la startup, Glimpse surpasse même GPT-6 Astra sur des tâches de raisonnement sur des graphiques scientifiques et de légendage de vidéos courtes. Sur d’autres benchmarks de raisonnement visuel, les résultats seraient compétitifs. Ces chiffres restent à confirmer de manière indépendante, comme toujours dans le secteur, mais ils indiquent une ambition claire : exceller là où la compréhension fine et itérative du visuel fait la différence.
Côté tarification, le modèle est proposé à 0,60 dollar par million de tokens en entrée et 3 dollars par million en sortie. Cela le place plus cher que des modèles légers comme Haiku ou Luna, mais moins onéreux que des systèmes de niveau intermédiaire tels que Sonnet ou Sol. L’accessibilité relative, combinée à une taille de modèle maîtrisée, constitue un argument pour des entreprises qui manipulent de gros volumes de données visuelles sans vouloir systématiquement payer le tarif des très grands modèles.
| Critère | Glimpse (Elorian) | Approche classique multimodale |
| Accès à l’image pendant le raisonnement | Dynamique et itératif | Généralement unique au début |
| Possibilité de zoom / crop / code | Native | Limitée ou absente |
| Taille relative du modèle | Plus compacte | Souvent très grande |
| Coût par million de tokens (approx.) | 0,60 $ in / 3 $ out | Variable selon le niveau |
| Force annoncée | Graphiques scientifiques, vidéos courtes | Description générale |
Le contexte de la levée de fonds et la sortie de stealth
Elorian n’est pas arrivée discrètement. La startup est sortie de stealth il y a environ six mois avec une levée de fonds seed de 55 millions de dollars, valorisant l’entreprise à 300 millions avant même le lancement d’un produit. Le tour a été co-mené par Striker Venture Partners, Menlo Ventures et Altimeter Capital, avec la participation de Nvidia et de Jeff Dean, chief scientist chez Google. Ce niveau de financement précoce témoigne de la confiance des investisseurs dans la thèse technique : le raisonnement visuel de nouvelle génération constitue un goulot d’étranglement majeur pour de nombreux secteurs.
Avoir levé autant d’argent avant de sortir un modèle public n’est pas anodin. Cela permet à l’équipe de se concentrer sur la recherche fondamentale plutôt que sur la monétisation immédiate, tout en bénéficiant du réseau et des ressources de partenaires industriels de premier plan. Nvidia y voit probablement un débouché pour ses puces, tandis que la présence de Jeff Dean apporte une caution scientifique forte.
Les premiers cas d’usage visés par Elorian
Les cibles prioritaires sont les organisations qui accumulent déjà d’importants volumes de données vidéo ou d’images complexes. On pense naturellement aux entreprises de robotique, aux laboratoires scientifiques, aux sociétés de médias et aux acteurs de la création. Dans ces environnements, pouvoir non seulement décrire mais véritablement interroger, mesurer et raisonner sur le contenu visuel de manière itérative ouvre des possibilités concrètes.
Un laboratoire qui analyse des séquences microscopiques, une équipe robotique qui doit interpréter des flux vidéo en temps réel, ou un studio qui souhaite extraire des informations précises de rushes peuvent tous bénéficier d’un système capable de « revenir voir » plutôt que de se fier à une représentation figée. À plus long terme, Elorian souhaite passer de la simple perception à l’action : construire un modèle de la scène et s’en servir pour choisir des actions, y compris pour piloter directement des robots.
L’ambition affichée pour l’année prochaine est claire : construire « le meilleur modèle de raisonnement visuel au monde », celui qui dominerait l’ensemble des tests de raisonnement visuel existants. C’est un objectif ambitieux, mais cohérent avec la stratégie d’avoir conçu l’architecture autour de la boucle visuelle plutôt que de l’ajouter après coup.
Disponibilité actuelle et accès au modèle
Glimpse est lancé sous forme de preview de recherche. L’accès via API est ouvert, tandis que l’interface de chat reste pour l’instant sur liste d’attente. Concrètement, les premiers utilisateurs peuvent déjà tester le comportement du modèle sur des tâches concrètes, même si l’expérience grand public n’est pas encore pleinement disponible. Cette stratégie permet de recueillir des retours ciblés tout en maîtrisant la charge sur l’infrastructure.
Pour les entreprises qui souhaitent expérimenter, l’API offre un point d’entrée immédiat. Elles peuvent intégrer le modèle dans leurs pipelines existants et observer comment la capacité de retour sur l’image modifie la qualité des résultats sur leurs propres données. C’est souvent dans ces contextes spécialisés que les différences avec les approches classiques deviennent les plus visibles.
Comparaison avec les autres approches du marché
Le paysage des modèles multimodaux évolue rapidement. Plusieurs acteurs ont exploré des formes d’attention visuelle plus fine ou des mécanismes de zoom. Cependant, peu ont fait de la boucle itérative le principe fondateur de l’architecture tout en maintenant une taille de modèle relativement contenue. La plupart des systèmes frontier restent très grands et optimisés pour une large gamme de tâches textuelles et visuelles, ce qui peut diluer les performances sur les cas purement visuels complexes.
Elorian mise sur une spécialisation plus marquée. En entraînant un modèle plus petit spécifiquement autour de la capacité de scratch space visuel, l’équipe espère obtenir de meilleurs résultats là où cela compte, tout en gardant des coûts d’inférence plus raisonnables. Cette stratégie rappelle certaines approches qui ont réussi dans d’autres domaines de l’IA : se concentrer sur un goulot d’étranglement précis plutôt que de viser l’universalité dès le départ.
- Architecture pensée autour du retour visuel plutôt qu’ajoutée
- Entraînement réalisé avec relativement peu de ressources
- Positionnement tarifaire intermédiaire
- Focus sur les tâches où la précision visuelle itérative est critique
- Ambition de leadership sur les benchmarks de raisonnement visuel
Implications pour la robotique et les systèmes physiques
L’un des horizons les plus intéressants évoqués par Elorian concerne le passage de la perception à l’action. Si un modèle peut construire une représentation riche et vérifiable d’une scène en y revenant régulièrement, il devient possible d’utiliser cette représentation pour décider d’actions concrètes. Dans le domaine de la robotique, cela pourrait se traduire par une meilleure capacité à interpréter l’environnement, à planifier des mouvements et à corriger en temps réel en fonction de ce qui est réellement observé.
Imaginez un robot qui doit assembler un objet complexe ou naviguer dans un espace encombré. Au lieu de se fier à une description textuelle approximative de la scène, il pourrait zoomer sur des zones critiques, vérifier des alignements, mesurer des distances et ajuster son plan en conséquence. Cette boucle de vérification visuelle continue rapproche le comportement de la machine de celui d’un opérateur humain attentif.
Les laboratoires scientifiques constituent un autre terrain fertile. L’analyse de données d’imagerie (microscopie, imagerie médicale, observations expérimentales) nécessite souvent de revenir sur des détails précis, de comparer des zones, ou de quantifier des phénomènes. Un système capable d’exécuter du code de mesure directement sur les régions pertinentes peut accélérer et fiabiliser ces workflows.
Défis techniques et limites potentielles
Toute nouvelle architecture apporte son lot de questions. Maintenir un accès dynamique à des images ou vidéos haute résolution pendant le raisonnement implique des contraintes de mémoire et de latence. Comment le modèle décide-t-il quand et où revenir sur l’image ? Comment éviter les boucles inutiles qui consomment des tokens sans améliorer la réponse ? Ces arbitrages sont au cœur de l’efficacité réelle du système.
Par ailleurs, la qualité des résultats dépendra fortement de la capacité du modèle à formuler des requêtes visuelles pertinentes. Un mauvais crop ou une mauvaise sélection de frame peut induire le raisonnement en erreur autant qu’un bon accès peut l’améliorer. L’entraînement doit donc apprendre non seulement à raisonner, mais aussi à « regarder » de manière stratégique.
Enfin, comme pour tout modèle, les performances annoncées sur des benchmarks internes devront être confrontées à des évaluations indépendantes et à des cas d’usage réels. Le secteur de l’IA a déjà connu des écarts notables entre les chiffres de laboratoire et le déploiement en production. Glimpse n’échappera pas à cette exigence de validation externe.
Le rôle des investisseurs et de l’écosystème
La composition du tour de table est révélatrice. Menlo Ventures et Altimeter Capital apportent une expertise de long terme dans les technologies profondes. Striker Venture Partners, de son côté, semble avoir misé tôt sur la thèse. La participation de Nvidia est particulièrement logique : un modèle qui effectue des allers-retours intensifs sur des données visuelles peut générer une charge de calcul significative, favorable à l’utilisation de GPU performants.
La présence de Jeff Dean ajoute une dimension scientifique. Avoir un chercheur de ce calibre parmi les investisseurs renforce la crédibilité technique du projet auprès de la communauté. Cela peut également faciliter des collaborations ou des échanges avec l’écosystème Google / DeepMind, même si Elorian reste une entité indépendante.
Ce type de financement précoce permet à l’équipe de recruter des talents rares et de se concentrer sur la recherche plutôt que sur la génération de revenus immédiats. Dans un marché où les meilleurs chercheurs sont courtisés par les géants, disposer de ressources significatives dès le départ constitue un avantage compétitif non négligeable.
Perspectives à moyen terme pour le raisonnement visuel
Si l’approche de Glimpse se confirme en production, elle pourrait influencer la conception des prochains modèles multimodaux. Plutôt que d’augmenter indéfiniment la taille des modèles pour compenser une représentation visuelle statique, certains acteurs pourraient choisir d’investir dans des mécanismes de retour dynamique plus sophistiqués. Cela ouvrirait la voie à des systèmes plus efficients sur les tâches purement visuelles tout en conservant de bonnes performances générales.
Pour les entreprises, l’enjeu est de déterminer dans quels cas d’usage le surcoût éventuel d’un modèle spécialisé se justifie par un gain de précision ou de fiabilité. Dans les domaines où une erreur d’interprétation visuelle a des conséquences importantes (sécurité, recherche scientifique, contrôle qualité industriel), la capacité de vérification itérative peut devenir un critère décisif.
À plus long terme, la combinaison d’un raisonnement visuel robuste et de capacités d’action pourrait accélérer le développement d’agents capables d’interagir avec le monde physique de manière plus autonome et plus fiable. Elorian positionne explicitement cette trajectoire comme une suite logique de ses travaux actuels.
Comment les entreprises peuvent commencer à expérimenter
Pour les organisations qui disposent déjà de données visuelles riches, le lancement en preview de recherche offre une opportunité de tester rapidement. L’accès API permet d’intégrer Glimpse dans des pipelines existants et de comparer les résultats avec ceux obtenus via des modèles multimodaux plus classiques. Les domaines les plus prometteurs pour un premier essai sont ceux où les détails fins, les mesures ou les comparaisons visuelles jouent un rôle central.
Il est recommandé de commencer par des tâches bien définies : extraction d’informations précises à partir de graphiques, analyse de séquences vidéo courtes, ou vérification de conformité visuelle. Ces cas permettent de mesurer concrètement l’apport du mécanisme de scratch space sans nécessiter une refonte complète des processus.
Comme pour toute technologie émergente, une phase d’évaluation rigoureuse reste indispensable. Documenter les gains de précision, les éventuels échecs et les coûts réels d’inférence permettra de décider si une adoption plus large se justifie. Elorian, de son côté, devrait continuer d’améliorer le modèle en fonction des retours des premiers utilisateurs.
Conclusion : une étape vers des IA qui regardent vraiment
Le lancement de Glimpse par Elorian marque une tentative sérieuse de dépasser la simple description d’images pour atteindre un raisonnement visuel plus proche de celui des humains. En intégrant nativement la possibilité de revenir sur la source, de zoomer, de sélectionner et de mesurer, le modèle adresse une limitation réelle des systèmes actuels. Que cette approche se généralise ou reste une spécialité dépendra des résultats en conditions réelles et de la capacité de l’équipe à tenir ses ambitions de leadership sur les benchmarks visuels.
Pour l’instant, la startup dispose des moyens financiers, du soutien d’investisseurs de premier plan et d’une thèse technique claire. Les prochains mois seront déterminants pour observer si le visual scratch space tient ses promesses au-delà des évaluations internes. Dans un domaine où la compréhension fine du monde visuel reste un défi majeur, toute avancée qui rapproche les machines d’une perception plus active et plus vérifiable mérite d’être suivie de près.
Les entreprises qui manipulent quotidiennement des images et des vidéos complexes ont tout intérêt à surveiller l’évolution de Glimpse et, lorsque l’accès le permet, à mener leurs propres expérimentations. Le fossé entre « décrire une image » et « raisonner avec elle » est encore large ; Elorian vient d’annoncer qu’elle compte le réduire significativement.
