

Et si le vrai pouvoir, dans la course à l’intelligence artificielle, n’était plus seulement de construire le modèle le plus brillant, mais de décider comment on le note ? Depuis que les classements publics sont devenus des armes de communication, chaque laboratoire cherche à paraître invincible. Pourtant, beaucoup de grilles d’évaluation datent d’une autre époque. Elles mesurent encore trop souvent une culture générale abstraite, alors que les systèmes d’aujourd’hui rédigent des contrats, analysent des risques financiers, écrivent du code en production et s’immiscent dans des décisions sensibles. C’est précisément dans cet écart que s’engouffre Vals, une jeune pousse californienne qui affirme vouloir devenir l’étalon du benchmarking IA.
Pourquoi Vals Veut Recalibrer Toute L’Industrie
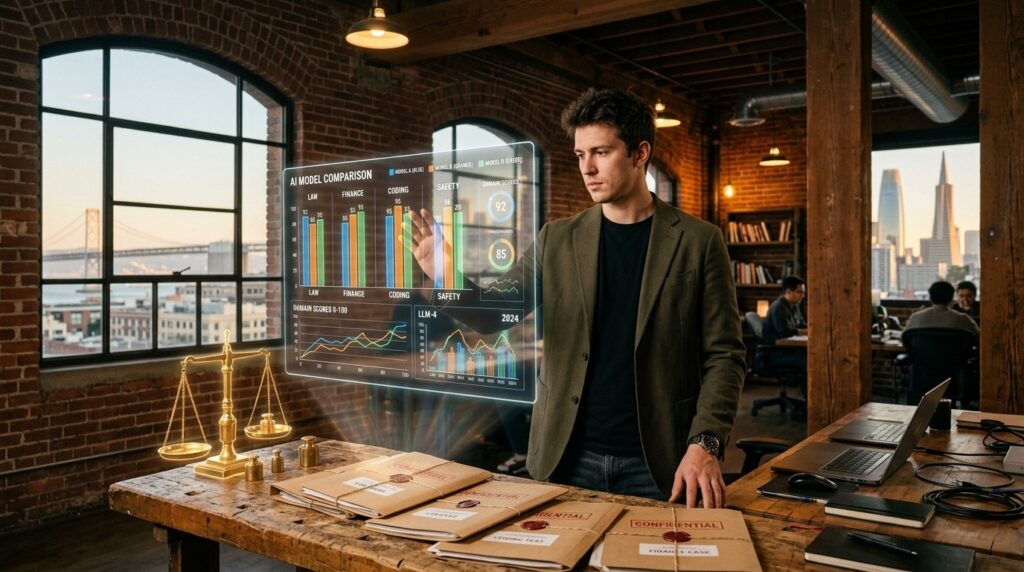
La scène est presque trop cinématographique pour être banale. Dans un ancien bâtiment de brique de Folsom Street, à San Francisco, là où l’on brassait autrefois de la bière à grande échelle, une équipe encore petite parle désormais de confiance publique, de dépôts boursiers et de conventions de Genève. Le contraste n’est pas un détail de décor. Il dit quelque chose du moment : l’IA n’est plus un sujet de laboratoire isolé. Elle devient une infrastructure économique. Et une infrastructure, tôt ou tard, exige des instruments de mesure plus sérieux que des quiz ouverts à tous.
Le constat de départ est simple, presque brutal. Les entreprises utilisent les scores pour se distinguer, pour rassurer des clients, pour justifier une levée de fonds. Un bon chiffre, c’est de la publicité. Le problème, c’est que les systèmes hérités n’ont pas été conçus pour des modèles capables d’apprendre vite, de mémoriser des épreuves publiques et de s’entraîner contre les examens eux-mêmes. Quand le barème est connu, la tentation de « bachoter » le test plutôt que de progresser réellement devient énorme. Vals construit son positionnement contre cette faille.
Un Fondateur Formé Au Croisement Du Terrain Et Du Labo
Rayan Krishnan a vingt-cinq ans. Ce chiffre circule beaucoup, parce qu’il choque un peu dans un secteur où l’on aime les récits de précocité. Mais l’âge n’explique pas à lui seul la trajectoire. Avant de lancer la société en 2024, il est passé par un stage chez Palantir, a travaillé pour Microsoft pendant ses études à Stanford, et a fréquenté le laboratoire d’intelligence artificielle de l’université. Autrement dit, il a vu à la fois la culture produit des grandes plateformes et l’obsession académique pour la mesure de « l’intelligence ».
Son diagnostic, reformulé sans langue de bois, tient en une phrase : les grilles universitaires n’arrivent plus à suivre la vitesse à laquelle de nouveaux systèmes capables arrivent sur le marché. On continue trop souvent à se demander si un modèle « sait assez de choses » pour réussir un examen de type barreau. Or la question décisive, selon lui, n’est plus celle-là. Elle devient : le système peut-il produire un livrable comparable à celui d’un professionnel compétent, dans un métier réel, avec ses contraintes, ses erreurs coûteuses et ses angles morts ?
On voyait arriver très vite des modèles très capables, et les benchmarks académiques ne suivaient pas cette avancée de frontière.
Rayan Krishnan, cofondateur de Vals
Cette phrase, entendue dans un bureau encore chargé de l’histoire industrielle du quartier, résume la bascule. L’évaluation ne devrait plus servir seulement à classer des cerveaux artificiels sur une échelle abstraite. Elle devrait vérifier ce que les entreprises promettent quand elles vendent de l’automatisation. Dans un monde où l’IA s’infiltre dans le droit, la finance, le code, la santé mentale ou la cybersécurité, le benchmark cesse d’être un accessoire marketing. Il devient un instrument de responsabilité.
Des Examens Fermés Pour Éviter Le Bachotage Des Modèles
La première rupture méthodologique est d’une clarté presque scolaire. Beaucoup de tests historiques sont publics. Tout le monde peut les lire, les recopier, les intégrer dans des jeux de données d’entraînement. Résultat : un modèle peut « réussir » sans forcément généraliser. Il a simplement trop bien révisé le sujet. Vals inverse la logique. Les supports précis ne sont pas divulgués. L’épreuve reste en partie secrète, comme un concours dont on connaît le programme mais pas le sujet du jour.
Ce choix n’est pas anodin. Il crée une tension commerciale intéressante. Les laboratoires paient pour être évalués, y compris lorsqu’ils risquent d’obtenir un résultat décevant. Pourquoi payer pour apprendre que l’on n’est pas encore assez bon ? Parce qu’un diagnostic honnête aide à corriger le tir. Krishnan compare ce modèle économique à celui d’un étudiant qui règle les frais d’une épreuve standardisée. On n’achète pas seulement un score. On achète une photographie exploitable de ses forces et de ses faiblesses.
- Les contenus d’épreuve restent non publics afin de limiter l’entraînement ciblé.
- Les scénarios privilégient des tâches métier plutôt qu’une culture générale hors sol.
- Les résultats servent autant à communiquer qu’à diagnostiquer les défaillances.
- Les commanditaires incluent désormais des acteurs privés et des agences fédérales.
Derrière cette liste se cache une idée plus politique qu’il n’y paraît. Si les classements deviennent des arguments de vente, alors la qualité du juge compte autant que la qualité du candidat. Une startup qui vend de la mesure occupe une position délicate : elle doit être assez indépendante pour rester crédible, assez proche de l’industrie pour comprendre les usages, assez discrète pour protéger ses protocoles. Vals joue précisément sur cette ligne de crête.
Mesurer Le Travail Réel, Pas Seulement La Culture Générale
Historiquement, beaucoup d’évaluations ont cherché à capturer une forme d’intelligence désincarnée. Connaître assez de faits pour passer un examen juridique théorique. Résoudre des problèmes de raisonnement dans un format académique. C’est utile, mais incomplet. Un modèle peut réciter des principes et pourtant produire un mémoire bancal, un contrat risqué ou un correctif logiciel fragile. Vals déplace le curseur vers la question du rendu. Le système est-il capable de livrer un travail dont la qualité se rapproche de celle d’un humain expérimenté dans un domaine donné ?
Le droit, la finance et le développement logiciel occupent une place centrale, parce que ce sont des univers où l’erreur a un prix. Un raisonnement approximatif n’est plus un détail de tableau de bord. C’est un risque opérationnel. L’entreprise insiste aussi sur le double regard : on ne cherche pas seulement les réussites spectaculaires. On cherche les dégâts possibles si ces systèmes « tournaient en liberté » dans le monde réel. Autrement dit, le benchmark n’est plus uniquement un concours de virtuosité. Il devient une cartographie des conséquences.
Cette bascule explique pourquoi le discours de la société séduit des investisseurs qui pensent déjà à la prochaine séquence du marché. Quand les modèles cessent d’être des démonstrations de salon pour devenir des pièces de l’économie, les directions générales ont besoin d’un langage commun. Pas seulement « plus intelligent ». Plutôt « assez fiable pour telle tâche, dans tel contexte, avec telle marge d’erreur ».
Une Expansion Vers Des Terrains Beaucoup Plus Sensibles
Le catalogue ne s’arrête plus aux métiers classiques. L’équipe évoque un benchmark sur l’amélioration récursive de soi, autrement dit la capacité d’un système à progresser en boucle. Elle mentionne aussi des travaux autour de la santé mentale, de la cybersécurité, de la biosécurité, et même du droit des conflits armés, pour observer comment des modèles appliquent des principes issus de la Convention de Genève. On quitte alors le simple comparatif commercial. On entre dans des zones où l’évaluation touche à la sécurité collective.
Ces terrains sont délicats, et c’est précisément pour cela qu’ils intéressent. Une grille trop légère sur la cybersécurité peut donner une fausse impression de maîtrise. Une évaluation trop théorique sur le droit humanitaire peut masquer des interprétations dangereuses. En ouvrant ces chantiers, Vals cherche à occuper une niche que peu d’acteurs académiques historiques ont industrialisée au rythme du marché. Le pari est ambitieux : devenir le lieu où l’on teste non seulement la performance, mais aussi la retenue.
Il faut toutefois garder la tête froide. Annoncer des protocoles sur des sujets aussi lourds n’équivaut pas, à soi seul, à les maîtriser. La crédibilité se construira dans la durée, par la robustesse des méthodes, la clarté des limites et la capacité à résister aux pressions des clients qui paient. C’est tout l’enjeu d’un juge privé dans un marché en surchauffe.
Le Financement Comme Signal, Pas Comme Preuve Absolue
En moins de deux ans, la société est passée du statut de nouvelle venue à celui d’acteur visible. Après une amorce menée par 8VC et Bloomberg Beta, elle a levé 40 millions de dollars en série A, avec Andreessen Horowitz en chef de file. Dans l’écosystème startup, ce type de ticket n’est jamais un détail. Il accélère le recrutement, légitime le discours auprès des grands comptes et place la marque dans le radar des laboratoires qui préparent déjà leur narration publique.
Le rythme interne suit la même pente. L’équipe, partie d’une poignée de personnes en début d’année, a déjà atteint environ vingt-cinq collaborateurs. La direction évoque encore une dizaine ou une quinzaine d’embauches, ainsi qu’un déménagement vers des locaux plus vastes. Une croissance aussi rapide, dans un métier de confiance, est à la fois une opportunité et un risque. Il faut scaler sans diluer la rigueur. Il faut vendre sans transformer le barème en produit de confort.
| Repère | Élément clé | Ce que cela change |
| Création | 2024 | Positionnement dès la vague des modèles frontière |
| Amorce | 8VC, Bloomberg Beta | Ancrage early-stage côté fonds spécialisés |
| Série A | 40 millions, a16z | Passage à une ambition d’étalon industriel |
| Équipe | De 8 à 25 personnes | Montée en charge commerciale et méthodologique |
| Revenu | Multiplié par huit | Signal d’adoption plus fort qu’un simple effet d’annonce |
Le chiffre le plus parlant n’est peut-être pas le montant levé. C’est la progression du chiffre d’affaires, présentée comme huit fois supérieure à celle de l’année précédente. Dans un métier où l’on pourrait craindre que personne ne veuille payer pour une mauvaise note, cette dynamique suggère que le marché a soif d’un tiers capable de dire non. Les entreprises qui achètent des modèles ont besoin d’arbitrer. Les éditeurs ont besoin de prioriser leurs correctifs. Les institutions publiques commencent, elles aussi, à chercher des grilles plus opérationnelles.
Pourquoi Les Entreprises Paient Pour Être Jugees
Le paradoxe n’est qu’apparent. Un score médiocre, s’il est précis, coûte moins cher qu’une illusion de performance. Mieux vaut découvrir en chambre d’évaluation qu’un assistant juridique invente une jurisprudence, qu’un copilote financier lisse un risque, ou qu’un agent de code introduit une faille élégante. Le paiement n’achète pas uniquement une médaille. Il achète une cartographie. Dans certains cas, il achète aussi un langage commun pour convaincre un conseil d’administration, un régulateur ou un client enterprise.
Les évaluations deviennent ainsi des critères d’achat. Une direction informatique n’a plus seulement à comparer des démonstrations. Elle peut s’appuyer sur des scénarios métier pour décider quel système déployer, dans quel périmètre, avec quelle supervision humaine. C’est une évolution discrète mais structurante. Le benchmark quitte la diapositive marketing pour entrer dans le dossier d’approvisionnement.
Vals a également lancé un programme tourné vers les agences fédérales. Le signal est clair : le besoin de mesure ne s’arrête pas aux startups de la côte Ouest. Les administrations, confrontées à des usages sensibles, ne peuvent se contenter d’un classement viral. Elles ont besoin de protocoles plus proches de leurs contraintes, de leurs responsabilités et de leurs seuils de tolérance au risque.
Quand Les Laboratoires Entrent En Bourse, Le Barème Change De Statut
Le fondateur insiste sur un horizon qui dépasse le simple comparatif technique. Des sociétés d’IA se préparent à une vie de société cotée. Dans cette séquence, les évaluations ne resteront pas de simples arguments de blog. Elles pourront peser dans la manière dont on parle d’investissements, d’usage réel et, potentiellement, de communication extra-financière ou réglementaire. Autrement dit, le benchmark quitte le laboratoire pour s’approcher du langage de la confiance publique.
À mesure que les modèles deviennent une pièce centrale de l’économie, les évaluations que nous menons vont orienter leur usage et peser dans la manière dont ces entreprises parlent de leurs investissements.
Rayan Krishnan
On peut lire cette phrase comme une ambition commerciale. On peut aussi la lire comme une description assez froide du prochain cycle. Dès qu’un actif technologique devient systémique, les marchés demandent des indicateurs. Pas forcément par vertu. Par besoin de comparaison. La question n’est donc plus seulement de savoir si Vals réussira à s’imposer. C’est de savoir qui, demain, écrira les règles de la preuve dans l’IA déployée.
Ce Que Cette Histoire Dit Du Marché Plus Large
Le succès d’une société d’évaluation révèle un basculement culturel. Pendant plusieurs années, la conversation publique a été saturée de records, de démonstrations et de classements facilement reproductibles. Cette phase n’était pas inutile. Elle a popularisé le sujet. Mais elle a aussi créé une inflation de scores dont la lisibilité s’érode. Plus les modèles sont proches les uns des autres sur des tests connus, plus le marché a besoin d’épreuves plus dures, plus contextualisées, plus proches du terrain.
Dans ce climat, une entreprise comme Vals n’est pas seulement une startup de plus. Elle est le symptôme d’une industrie qui commence à se professionnaliser. On passe de « regarder ce que le modèle sait dire » à « regarder ce que le modèle sait faire sans casser quelque chose ». Cette phrase paraît évidente. Elle ne l’est pas. Elle suppose d’accepter que la performance brute ne suffit plus, et que la confiance se construit aussi en documentant les échecs.
Les secteurs déjà très réglementés comprendront vite l’intérêt. Une banque, un cabinet, un hôpital ou une agence de sécurité n’achète pas un tableau de médailles. Ils achètent une réduction d’incertitude. Si un tiers indépendant, ou du moins suffisamment crédible, peut comparer des systèmes sur des tâches proches de leur quotidien, le cycle de décision s’accélère. C’est aussi pour cela que le sujet dépasse la seule Silicon Valley. Il concerne toute organisation qui s’apprête à déléguer une partie de son travail cognitif.
Les Limites Qu’Il Faudra Surveiller Sans Complaisance
Un article honnête ne peut pas s’arrêter à l’éloge du positionnement. Plusieurs tensions resteront ouvertes. D’abord, le conflit d’intérêts potentiel : le client paie l’évaluateur. Ensuite, la tentation d’étendre le catalogue plus vite que la rigueur méthodologique. Enfin, le risque de voir apparaître une nouvelle forme d’optimisation, plus subtile, dès que les laboratoires comprendront assez bien les familles de tâches pour s’y adapter sans connaître les sujets exacts.
- La confidentialité des épreuves protège contre le bachotage, mais réduit la vérifiabilité publique.
- Le modèle payant crée une relation commerciale qu’il faudra sanctuariser par des protocoles stricts.
- L’élargissement vers des domaines sensibles exige une expertise rare, pas seulement une ambition narrative.
- La croissance de l’équipe devra préserver une culture de doute plutôt qu’une culture de classement.
Ces réserves ne disqualifient pas le projet. Elles en précisent le niveau d’exigence. Devenir un étalon, ce n’est pas seulement lever des fonds et recruter. C’est accepter d’être contesté, audité, comparé. C’est aussi admettre qu’aucune grille unique ne capturera jamais toute la complexité d’un système généraliste. Le bon évaluateur n’est pas celui qui promet la vérité totale. C’est celui qui documente clairement ce qu’il mesure, ce qu’il ne mesure pas, et dans quelles conditions le résultat reste interprétable.
Une Leçon Plus Large Pour Les Fondateurs Et Les Acheteurs
Pour les fondateurs, l’histoire de Vals rappelle qu’il existe encore de la valeur dans les couches « ennuyeuses » de l’industrie. Mesurer, certifier, comparer, documenter : ces verbes font moins rêver qu’entraîner un modèle géant. Pourtant, ils deviennent indispensables dès que le marché bascule de l’expérimentation vers le déploiement. Les infrastructures de confiance se construisent souvent après la première vague d’enthousiasme, rarement avant.
Pour les acheteurs, la leçon est différente. Un classement isolé ne dit presque rien. Il faut regarder la nature des tâches, le degré d’exposition des sujets, la proximité avec le métier, la prise en compte des échecs et la gouvernance de l’évaluateur. Autrement dit, choisir un modèle, demain, reviendra de plus en plus à choisir aussi la manière dont on accepte d’être mesuré. C’est une bascule culturelle autant que technique.
On peut même aller plus loin. Dans quelques années, il est probable que les organisations les plus matures tiendront un double tableau de bord : la performance interne de leurs propres flux de travail, et la performance externe des systèmes qu’elles achètent. Les entreprises qui sauront relier ces deux lectures auront un avantage. Les autres continueront de collectionner des scores sans vraiment savoir ce qu’ils autorisent dans le réel.
Ce Qu’il Faut Retenir De Cette Poussée Californienne
Vals n’invente pas l’idée d’évaluer l’intelligence artificielle. Elle tente d’en changer le centre de gravité. Moins de quiz ouverts, plus de tâches fermées. Moins de culture générale hors sol, plus de livrables métier. Moins de records facilement reproductibles, plus d’attention aux conséquences. Dans un marché où chaque laboratoire cherche un angle pour paraître supérieur, cette repositionnement a une force narrative évidente. Il a surtout une utilité concrète si la méthode tient ses promesses.
Le bâtiment de brique de Folsom Street, ancien lieu de production industrielle, devient alors une métaphore presque trop parfaite. On n’y fabrique plus de bière. On y fabrique des instruments pour juger des machines qui, demain, fabriqueront une partie du travail intellectuel. La question n’est plus de savoir si l’industrie a besoin de meilleurs barèmes. Elle en a besoin. La vraie question est de savoir si un acteur privé, jeune, bien financé et en croissance rapide, peut devenir assez légitime pour que ses notes pèsent réellement dans les décisions publiques et privées.
Pour l’instant, les signaux s’alignent : capital, clients payants, ouverture vers les agences, extension vers des domaines sensibles, discours clairement branché sur la prochaine séquence boursière de l’IA. Reste le plus difficile, celui que aucun communiqué ne règle. Tenir la rigueur quand le succès accélère. Rester lisible quand les sujets se compliquent. Continuer à mesurer ce qui dérange, pas seulement ce qui flatte. C’est à cette condition, et à celle-là seulement, qu’une startup de benchmarking peut prétendre devenir autre chose qu’un nouvel étage du marketing : un véritable instrument de confiance.
